PB级数据库 数据处理与存储支持服务详解
在数据量爆炸式增长的今天,PB(Petabyte,1 PB = 1024 TB)级数据库已成为大型互联网企业、科研机构和金融行业的核心基础设施。所谓PB数据库,并不是指某一种特定的数据库产品,而是指能够稳定承载、处理和管理PB级数据规模的数据库系统及其配套的数据处理与存储支持服务。
一、PB数据库的基本概念
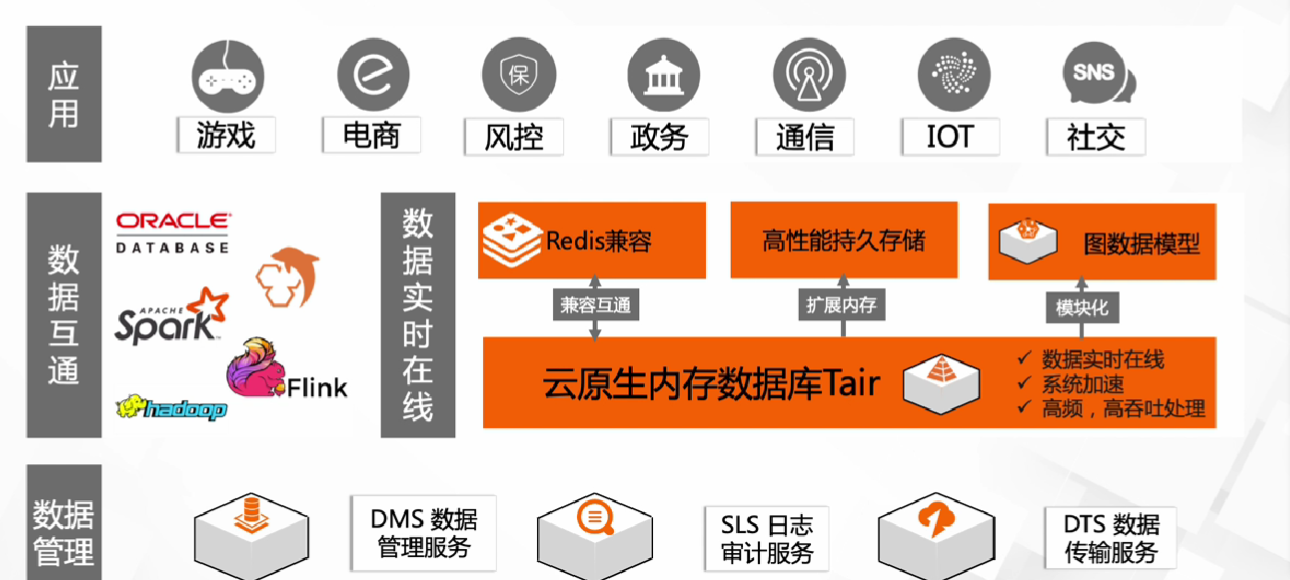
PB数据库的核心特征是数据总量达到PB级别,且需要在高并发、低延迟的条件下完成读写、查询和分析。常见的实现形态包括分布式关系型数据库(如TiDB、OceanBase)、分布式NoSQL数据库(如HBase、Cassandra)、数据仓库(如ClickHouse、Doris)以及对象存储与计算分离架构。它们通常采用分片(Sharding)、多副本、一致性协议等技术,将数据分散到成百上千个节点上,从而实现横向扩展。
二、数据处理支持服务
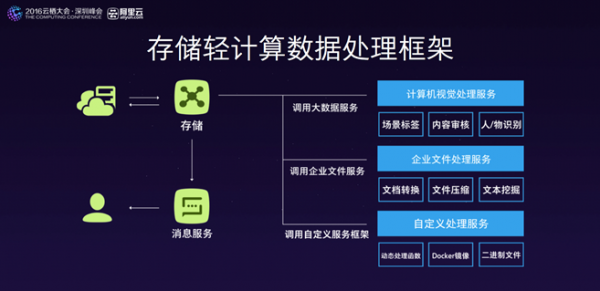
PB级数据库的数据处理服务主要包括以下几类:
- 批量数据处理:通过MapReduce、Spark等计算框架对海量历史数据进行离线清洗、转换和聚合,支撑报表生成与数据挖掘。
- 流式数据处理:借助Flink、Kafka等组件实现实时数据摄入与增量计算,满足风控、监控、推荐等实时业务需求。
- 交互式查询:提供SQL引擎和向量化执行能力,支持分析师对PB级数据进行秒级到分钟级的即席查询。
- 数据治理与质量管理:包括元数据管理、血缘追踪、数据质量校验和权限控制,确保数据可信可控。
三、存储支持服务
存储层是PB数据库的基石,相关支持服务通常包括:
- 分布式文件系统与对象存储:如HDFS、Ceph、S3兼容存储,提供高吞吐、高可靠的底层存储能力。
- 分层存储与冷热分离:将热数据放在高性能SSD或内存中,冷数据下沉至低成本大容量介质,平衡性能与成本。
- 多副本与容灾备份:通过副本机制和跨机房复制保障数据可靠性,并提供快照、备份恢复服务。
- 弹性扩缩容:在存储容量或访问压力变化时,支持在线扩容和数据再均衡,避免业务中断。
四、典型应用场景
PB数据库及数据存储支持服务广泛应用于用户行为分析、日志审计、物联网数据汇聚、金融交易流水存储、科学计算与基因测序等领域。在这些场景中,系统不仅需要“存得下”,更要“算得快”“管得住”。
五、建设要点
构建PB级数据处理与存储支持服务时,应重点关注:架构的可扩展性、数据一致性与可用性的权衡、成本优化、安全合规以及运维自动化。只有将数据库、计算引擎与存储服务协同设计,才能真正发挥PB级数据资产的价值。
如若转载,请注明出处:http://www.hsrcztc.com/product/43.html
更新时间:2026-11-03 05:21:24